
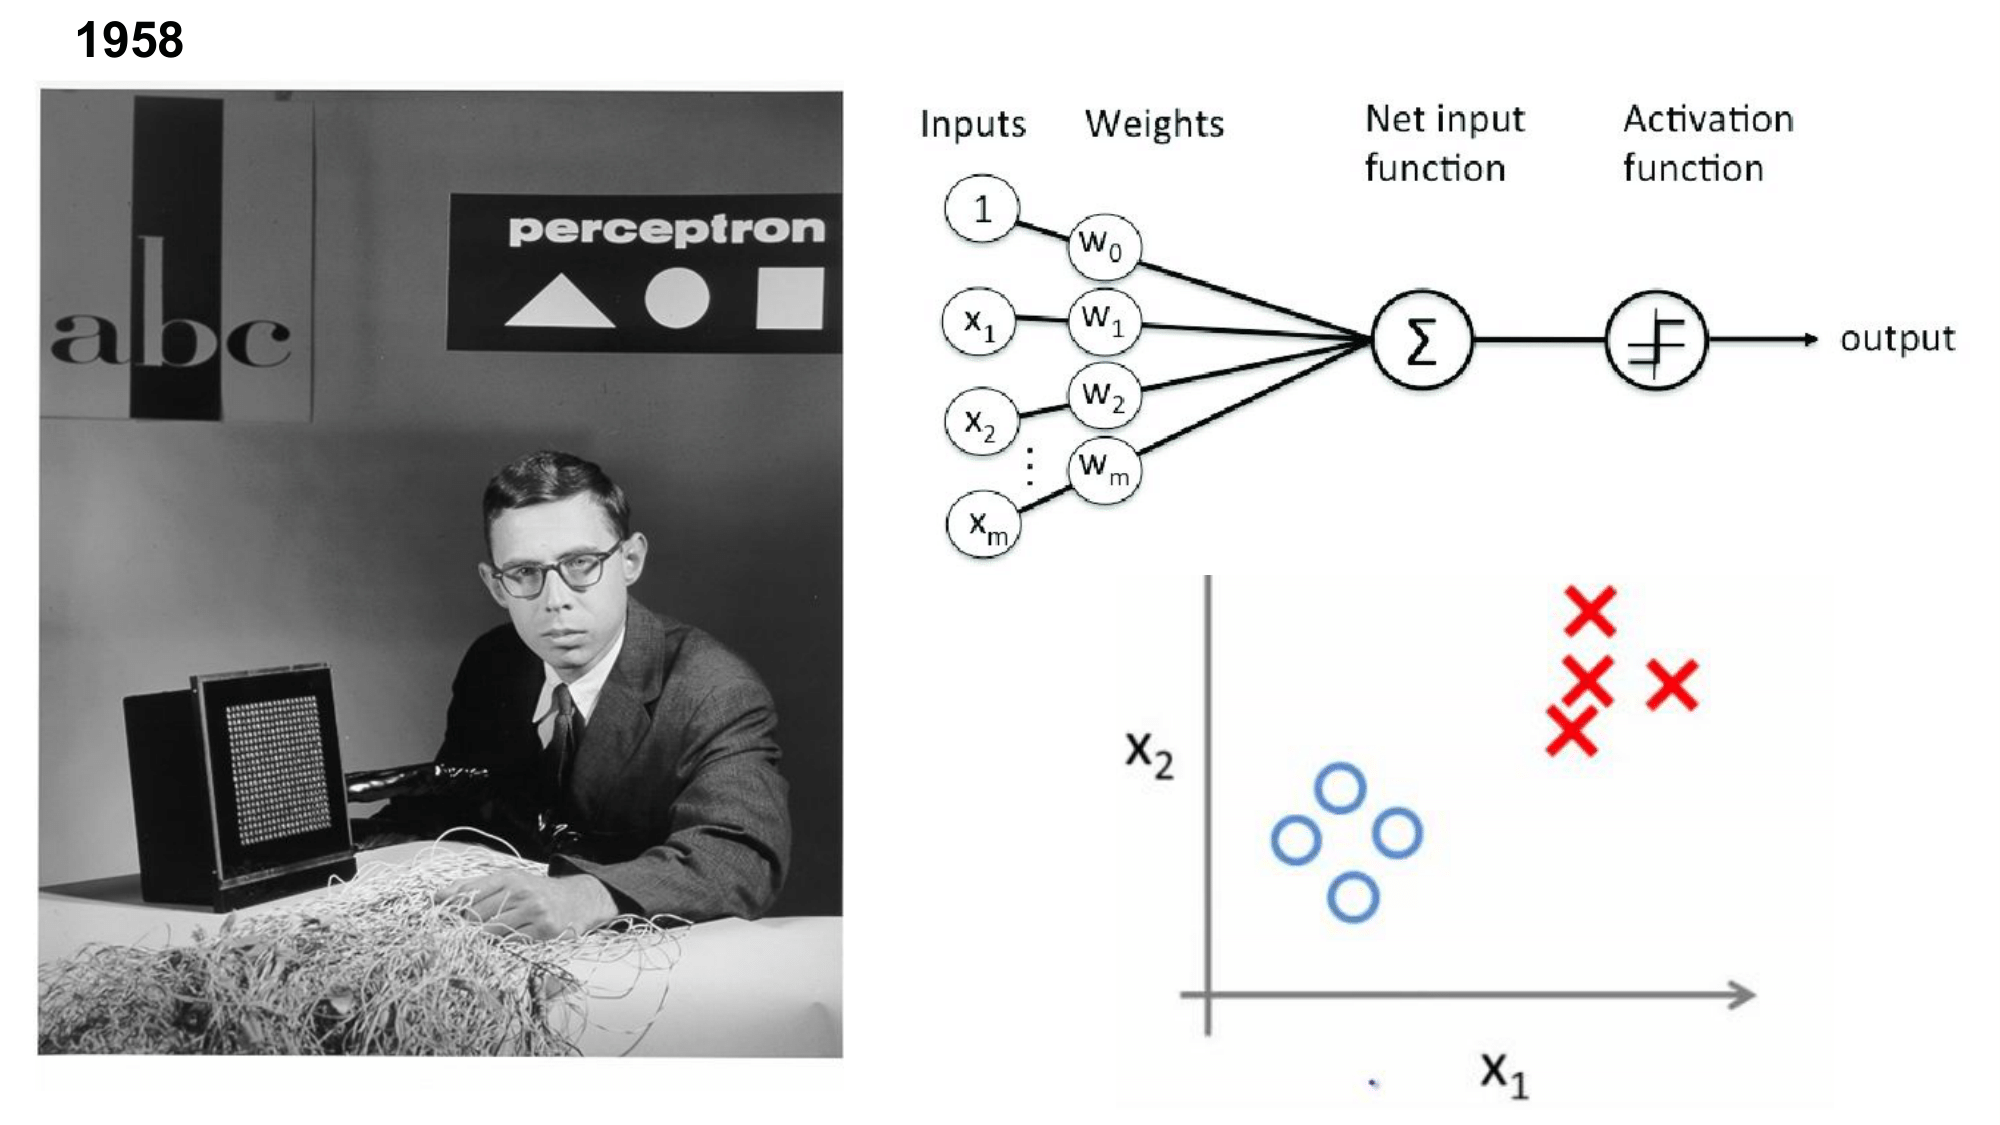
Le 8 juillet 1958, les lecteurs du très sérieux New York Times découvrent un article au titre sensationnel : la marine américaine vient de révéler l'existence d'une machine révolutionnaire, baptisée Perceptron. D'après l'article, ce dispositif serait :
« L'embryon d'un ordinateur électronique qui, selon les prévisions de la Navy, sera bientôt capable de marcher, parler, voir, écrire, se reproduire et avoir conscience de son existence. »
À l'origine de ce bouleversement se trouve un jeune psychologue et neurobiologiste de 30 ans du laboratoire aéronautique de Cornell : Frank Rosenblatt (1928-1971).
Avec le Perceptron, Rosenblatt ne se contente pas d'écrire un algorithme : il pose la première brique de ce que nous appelons aujourd'hui les réseaux de neurones artificiels et le Machine Learning. Pourtant, cette aventure scientifique fulgurante allait être stoppée net par une querelle théorique d'anthologie et précipiter l'intelligence artificielle dans son tout premier « hiver ».
1. Aux origines : Du neurone biologique au neurone formel (1943)#
Pour comprendre la percée de Rosenblatt, il faut remonter quinze ans en arrière, en pleine Seconde Guerre mondiale.
En 1943, le neurophysiologiste Warren McCulloch et le jeune prodige logicien Walter Pitts publient un article fondateur : A Logical Calculus of the Ideas Immanent in Nervous Activity. Inspirés par la biologie du cerveau, ils proposent une simplification mathématique extrême du fonctionnement synaptique : le neurone formel.
    Entrée x₁ ───► [ Poids w₁ ] ──┐
    Entrée x₂ ───► [ Poids w₂ ] ──┼──► [ Somme pondérée Σ ] ──► [ Seuil binaire f ] ──► Sortie y ∈ {0, 1}
    Entrée x₃ ───► [ Poids w₃ ] ──┘
Dans ce modèle : 1. Un neurone reçoit plusieurs signaux électriques binaires (\(0\) ou \(1\)). 2. Chaque signal est multiplié par une intensité de connexion (excitation ou inhibition). 3. Si la somme pondérée dépasse un certain seuil critique, le neurone « décharge » et émet un signal \(1\) ; sinon, il reste au repos (\(0\)).
McCulloch et Pitts démontrent un résultat théorique fascinant : en combinant judicieusement ces neurones artificiels, on peut reproduire toutes les portes logiques fondamentales (ET, OU, NON) et donc implémenter n'importe quelle fonction booléenne ou machine de Turing.
[!WARNING] La limite du neurone de McCulloch-Pitts :
Ce modèle était purement statique. Les poids et les seuils devaient être calculés et câblés manuellement par un ingénieur. Le système n'avait aucun moyen d'ajuster ses paramètres de façon autonome : il n'apprenait rien.
En 1949, le neuropsychologue canadien Donald Hebb introduit une hypothèse clé dans son ouvrage The Organization of Behavior : la plasticité synaptique. Résumée par le célèbre adage « Neurons that fire together, wire together », cette théorie postule que la force de connexion entre deux neurones augmente lorsqu'ils sont activés simultanément.
La scène était prête : il manquait un algorithme concret pour formaliser cet apprentissage.
2. L'éclair de génie de Frank Rosenblatt (1957)#
En 1957, Frank Rosenblatt franchit le pas décisif. Au Cornell Aeronautical Laboratory, il conçoit le Perceptron.
Son intuition est novatrice : plutôt que de programmer les règles à la main, la machine doit découvrir elle-même les poids optimaux par essais et erreurs, en analysant des exemples étiquetés. C'est l'acte de naissance du Machine Learning supervisé.
Le formalisme mathématique#
Soit un vecteur d'entrées \(\mathbf{x} = (x_1, x_2, \dots, x_n)\) et un vecteur de poids ajustables \(\mathbf{w} = (w_1, w_2, \dots, w_n)\), accompagnés d'un biais \(b\) (ou seuil \(\theta = -b\)) :
La sortie prédite \(\hat{y}\) est déterminée par une fonction d'activation à échelon (fonction de Heaviside) :
La règle d'apprentissage du Perceptron (Perceptron Learning Rule)#
Pour entraîner son modèle, Rosenblatt propose un mécanisme d'ajustement automatique d'une élégance remarquable :
- Initialiser tous les poids \(w_i\) et le biais \(b\) à zéro (ou à de petites valeurs aléatoires).
- Pour chaque exemple d'entraînement \((\mathbf{x}, y)\) :
- Calculer la prédiction \(\hat{y} \in \{0, 1\}\).
- Comparer \(\hat{y}\) avec la valeur réelle \(y\).
- Mettre à jour chaque poids selon la règle :
où \(\eta \in ]0, 1]\) représente le taux d'apprentissage (learning rate).
  ┌────────────────────────────────────────────────────────────────────────┐
  │                           Analyse de l'Erreur                          │
  ├────────────────────────────────────────────────────────────────────────┤
  │ Si y = ŷ     ==>  (y - ŷ) = 0   : Aucune modification, prédiction juste│
  │ Si y = 1, ŷ = 0 ==>  (y - ŷ) = +1 : Faux négatif -> on augmente les poids│
  │ Si y = 0, ŷ = 1 ==>  (y - ŷ) = -1 : Faux positif -> on diminue les poids │
  └────────────────────────────────────────────────────────────────────────┘
En 1962, le mathématicien Albert Novikoff publie le théorème de convergence du Perceptron : si les données sont linéairement séparables, l'algorithme garantit de trouver une frontière de décision parfaite en un nombre fini d'itérations.
3. Le Mark I Perceptron : Un colosse électromécanique#
Le Perceptron n'était pas seulement une équation théorique. Financé par l'Office of Naval Research (ONR), Rosenblatt et son équipe construisent une machine physique sur mesure : le Mark I Perceptron.
Pesant plusieurs centaines de kilogrammes, la machine est reliée à un capteur optique inédit : une « rétine » carrée composée d'une matrice de \(20 \times 20\) photorésistances au sulfure de cadmium (soit 400 pixels d'entrée).
   [ Rétine 20x20 ] ──► [ Câblage aléatoire ] ──► [ 512 Potentiomètres Motorisés ]
    (400 capteurs)        (Couche d'association)       (Moteurs électriques DC)
Chaque poids synaptique était matérialisé par un potentiomètre rotatif. Lors de l'apprentissage, lorsque l'algorithme décidait de modifier un poids, un signal électrique activait un petit servomoteur à courant continu qui faisait tourner physiquement l'axe du potentiomètre pour ajuster sa résistance !
Les observateurs de l'époque étaient ébahis : on présentait à la machine des cartes perforées ou des dessins de formes géométriques (des triangles, des carrés, des lettres \(A\) et \(B\)), et après plusieurs passages accompagnés d'un vrombissement de petits moteurs, l'engin parvenait à classer correctement les nouvelles images jamais vues.
L'enthousiasme médiatique et scientifique est à son comble. Les tenants du connexionnisme pensent avoir percé le secret de l'intelligence.
4. Le coup d'arrêt : Minsky, Papert et le piège du XOR (1969)#
Mais à la fin des années 1960, une rivalité scientifique féroce oppose deux visions de l'intelligence artificielle :
- Le camp symbolique (mené par Marvin Minsky et John McCarthy au MIT), qui soutient que l'intelligence réside dans la manipulation logique de symboles et de règles formelles.
- Le camp connexionniste (incarné par Frank Rosenblatt), qui soutient que l'intelligence émerge de réseaux d'unités simples apprenant par ajustement statistique.
En 1969, Marvin Minsky et Seymour Papert publient un livre au titre sobre mais à l'effet dévastateur : Perceptrons: An Introduction to Computational Geometry.
Dans cet ouvrage rigoureux, Minsky et Papert démontrent avec une clarté mathématique implacable les limites intrinsèques du modèle de Rosenblatt : un Perceptron simple ne peut séparer que des ensembles linéairement séparables (séparables par une simple ligne droite dans le plan, ou un hyperplan dans des dimensions supérieures).
Ils mettent alors en lumière l'incapacité du Perceptron à apprendre la plus simple des opérations logiques non-linéaires : le OU Exclusif (XOR).
       Table XOR :                     Représentation géométrique :
  ┌────┬────┬───────────┐                 x₂ ▲
  │ x₁ │ x₂ │ y (XOR)   │                    │
  ├────┼────┼───────────┤                  1 ┼   ● (0,1) [y=1]     x (1,1) [y=0]
  │ 0  │ 0  │  0        │                    │
  │ 0  │ 1  │  1        │                    │
  │ 1  │ 0  │  1        │                    │
  │ 1  │ 1  │  0        │                  0 ┼   x (0,0) [y=0]     ● (1,0) [y=1]
  └────┴────┴───────────┘                    └─────────┼───────────────┼────────► x₁
                                                       0               1
                                           Impossible de tracer une seule droite
                                           séparant les '●' des 'x' !
Minsky et Papert ne se contentent pas de prouver la défaillance du Perceptron à une seule couche. Dans un passage teinté d'un profond pessimisme, ils avancent que l'extension aux réseaux multicouches (Multi-Layer Perceptrons) sera vouée à l'échec ou impossible à entraîner de manière efficace.
[!IMPORTANT] Le coup fatal pour les crédits de recherche :
Les conclusions du livre de Minsky et Papert sont interprétées par la communauté scientifique et les organismes subventionnaires (dont la DARPA américaine) comme la preuve définitive de l'inutilité des réseaux de neurones. Les financements sont brutalement coupés.
5. Le premier hiver de l'IA et la tragédie de Rosenblatt#
La publication de Perceptrons sonne le glas de la recherche connexionniste pour plus d'une décennie. C'est l'entrée dans le premier hiver de l'IA (AI Winter). Les laboratoires ferment leurs programmes sur les neurones, et les chercheurs connexionnistes sont marginalisés.
Pour Frank Rosenblatt, le choc est terrible. Défendant inlassablement le potentiel des réseaux multicouches face au scepticisme ambiant, il tente de concevoir des architectures plus profondes.
Mais le destin interrompt brutalement son œuvre : le 11 juillet 1971, le jour exact de son 43ᵉ anniversaire, Frank Rosenblatt disparaît tragiquement dans un accident de voilier sur la baie de Chesapeake.
Il ne verra jamais la réhabilitation triomphale de ses idées.
6. Récapitulatif : L'évolution du neurone artificiel#
| Modèle | Auteurs & Année | Nature des entrées / sorties | Mécanisme d'apprentissage | Limite principale |
|---|---|---|---|---|
| Neurone Formel | McCulloch & Pitts (1943) | Binaires (\(0\) ou \(1\)) | Aucun (poids statiques câblés manuellement) | Ne s'adapte pas, n'apprend rien |
| Perceptron Simple | Frank Rosenblatt (1957) | Réelles \(\to\) Binaire | Règle d'erreur itérative (\(\Delta w = \eta(y-\hat{y})x\)) | Incapable de résoudre le XOR (linéarité) |
| Perceptron Multicouche (MLP) | Rumelhart, Hinton, Williams (1986) | Réelles continues | Rétropropagation du gradient (Backprop) | Résout les problèmes non linéaires complexes |
[!NOTE] Ne pas confondre Perceptron et Régression Logistique :
Bien que proches dans leur formulation, le Perceptron originel de Rosenblatt utilise une fonction d'activation discontinue (l'échelon de Heaviside) et n'a pas de notion probabiliste ni de gradient lisse. La régression logistique utilise une sigmoïde continue, une fonction de coût (entropie croisée) et optimise ses poids par descente de gradient différentiable.
Ce qu'il faut retenir#
- L'apprentissage supervisé est né avec Rosenblatt : Le Perceptron (1957) a démontré pour la première fois qu'une machine pouvait ajuster ses propres paramètres à partir de données étiquetées sans être explicitement programmée règle par règle.
- Le Mark I était une merveille d'ingénierie : Avec sa rétine optique et ses potentiomètres motorisés physiques, il a matérialisé le premier réseau de neurones fonctionnel de l'histoire.
- Le problème du XOR a causé le premier hiver de l'IA : La démonstration mathématique de Minsky et Papert en 1969 sur l'incapacité du Perceptron simple à traiter les frontières non-linéaires a stoppé net les financements de la recherche connexionniste pendant 15 ans.
- Une intuition prophétique : Il faudra attendre le milieu des années 1980 et l'avènement de la rétropropagation du gradient pour que les réseaux multicouches surmontent enfin la barrière du XOR et réveillent la révolution du Deep Learning.
Dans le prochain numéro de la Rubrique ML, nous découvrirons comment les travaux pionniers de Yann LeCun sur les réseaux convolutifs (CNN) ont permis aux machines de poser un regard inédit sur le monde visuel.
Commentaires